哈啰,我的老伙计们!我是小谱。
这两年用AI做歌,我们一直在研究一件事:提示词到底怎么写,模型才听得懂。流派、人声、BPM、乐器、情绪、段落、制作方式……Suno V6出来以后,甚至连“这句到底怎么唱”都能继续往细了写。可另一条路线也越来越明显。你可以少解释一点,直接把东西给它看。
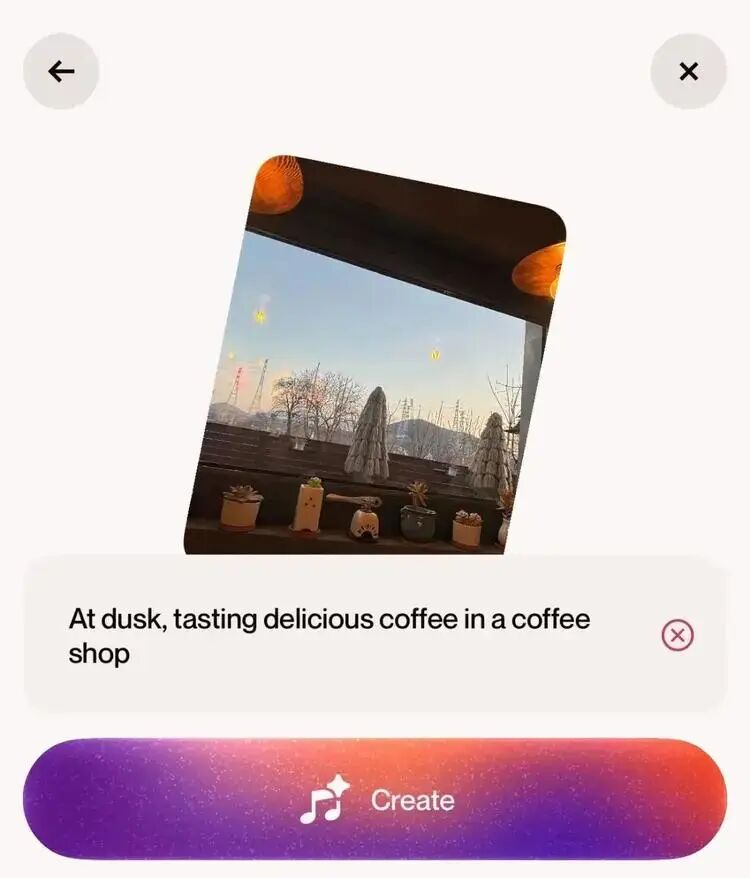
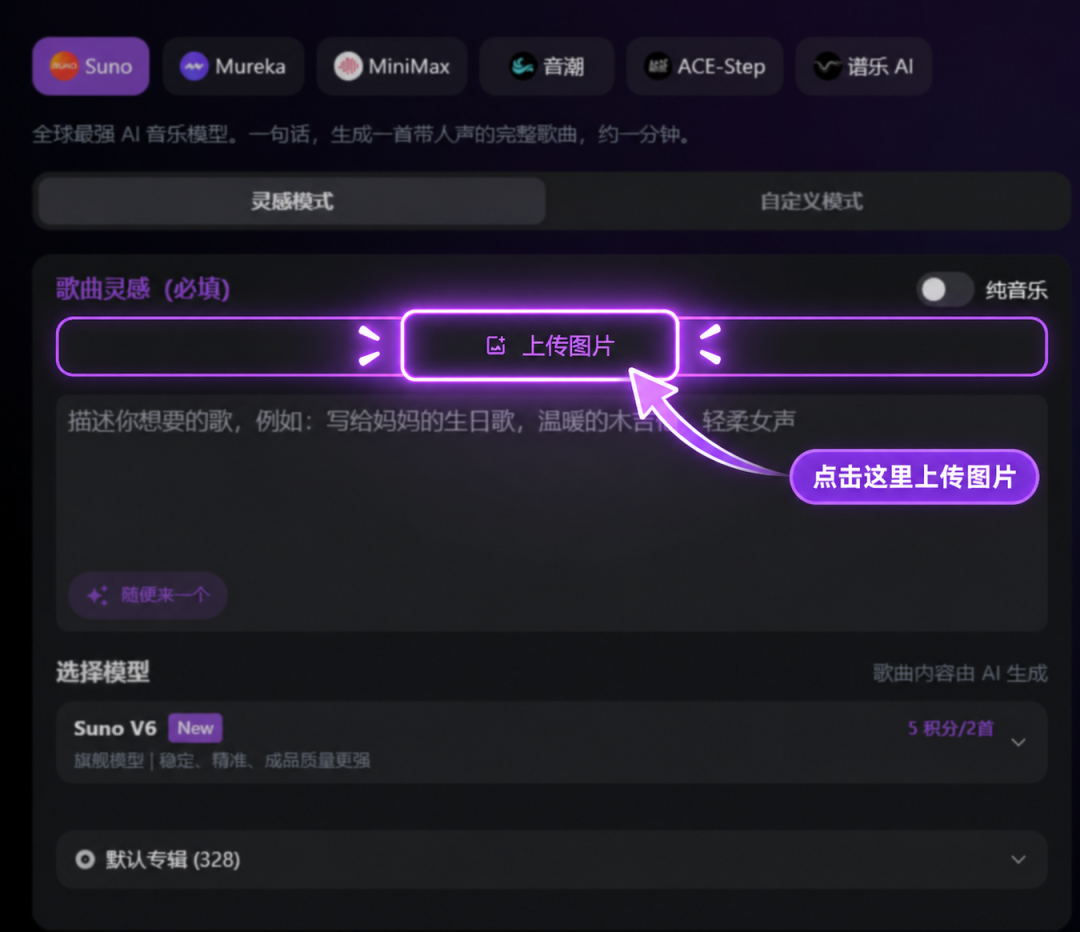
Suno早在2024年就做过Scenes,让照片和视频直接成为歌曲灵感;到了V6,官方进一步把text、audio、images、video全部列进创作输入里。谱乐AI现在也已经把图片输入接进了Suno灵感模式,上传一张照片,就可以直接从画面开始做歌。这个功能真正有意思的地方,远超过“看图写歌”四个字——它背后代表的是AI音乐的一次交互变化:Prompt正在从“完整说明书”,变成“补充说明”。
01
很多人缺的从来都不是音乐,他们缺的是“这张图该配什么音乐”
站在音乐生成工具的角度,我们很容易默认:用户打开Suno,就是为了“创作一首歌”。真实场景往往反过来。很多人手里先有内容:一组旅行照、一张毕业合影、一张情侣照片、一幅自己画的插画、一个品牌视觉、一段刚刚记录下来的生活。然后才会冒出一个问题:“这个画面,应该配什么音乐?”
以前解决这件事,通常要进入音乐库。搜索“治愈”“旅行”“青春”“浪漫”,再从几百首结果里一首一首听。
AI音乐正在提供另一种逻辑:先把你的内容交给模型,再让音乐围绕内容生成。一个是“从已有音乐里找最接近的”,另一个是“围绕这份内容重新做一首”。这两种逻辑的区别很大。前者属于检索,后者开始接近真正的定制配乐。
02
照片其实是一条被压缩过的超级Prompt
假设你上传一张照片。画面里是傍晚的海边:天空偏橙,一个人背对镜头,海面很空,人物很小,整个画面带一点离开、回忆或者松弛的感觉。如果把这些东西全部翻译成传统音乐Prompt,你可能会开始写:
warm nostalgic indie pop, sunset atmosphere, intimate vocal, soft acoustic guitar, gentle drums...
但照片里包含的信息远远更多:颜色、光线、人物数量、人物距离、场景类型、天气、空间、构图、视觉重心,甚至人物和环境之间的关系。一张图本身,就是一大包上下文。
所以图片输入真正减少的,并不只是打字。它减少的是一个更麻烦的步骤:把视觉感受翻译成音乐术语。以前:画面→用户理解情绪→用户想流派→用户组织Prompt→模型生成音乐。现在:画面→模型先理解→用户补充自己的意图→生成音乐。中间那层“翻译工作”开始由模型承担。
03
这可能比“提示词越来越专业”更重要
我们最近一直在教V6怎么写提示词:八段风格框、人声表演词、Variety、Style Influence、Weirdness。这些技巧对想精准控制作品的人非常有价值。但AI工具要继续扩大用户范围,还要解决另一个问题:大量用户根本不会主动学习这些东西。一个人可能不会说“我想要一首78 BPM、暖色模拟质感、低饱和鼓组、亲密女声的Indie Folk”。他完全知道自己想要什么,只是表达方式不同。他会拿出手机里的照片说:“就这个感觉。”
这其实才是多模态AI真正有价值的地方。模型开始理解人的原始表达方式。图片是一种表达,哼唱是一种表达,语音备忘录是一种表达,一段文字也是一种表达。Suno V6官方把文字、音频、图片和视频放到同一套创作能力里,本质上是在把“音乐提示词”从一种固定格式,扩展成各种可以表达意图的素材。
04
以后“配乐”的逻辑,可能会从找歌变成读内容
这一点对短视频和内容创作者尤其重要。今天我们做内容,画面和音乐通常是分开的两套流程:先拍,再剪,然后去找BGM。于是经常出现一种情况:画面很私人,音乐却是所有人都在用的那一首。AI音乐提供了另一种可能。每份内容都可以拥有自己的音乐。
同样是海边照片:有人想表达自由,有人想表达失恋,有人想表达毕业旅行,有人想表达“终于离开这座城市”。画面提供第一层信息,用户自己的故事再提供第二层信息,音乐最终根据两者共同生成。所以未来AI配乐真正有价值的能力,可能包含两层:模型先读懂内容,人再告诉模型自己怎么看这份内容。这样生成出来的东西才有机会从“符合场景”,继续走到“符合这个人”。
05
这也解释了为什么“灵感模式”这个名字越来越准确
谱乐AI现在已经把这项能力放进了Suno灵感模式。很多真正的创作,本来就不会从一句完整Prompt开始。它可能从一张旧照片、一个人在街上的背影、一次旅行、一个角色设定、一张自己很喜欢的插画,甚至某个特别想留下来的瞬间开始。你先把图片上传,模型给出第一版音乐,然后再去决定:情绪要不要更明亮,人声要不要换,歌词想讲什么,节奏应该快一点还是慢一点。于是创作流程会从“先写完整答案,再让AI执行”,逐渐变成“先给AI一个世界,再一起把答案找出来”。这也是“灵感”真正适合AI的地方,它不要求你一开始就知道最终作品长什么样。
06
下一代AI音乐,真正争的可能是“谁更懂你的内容”
过去我们比较音乐模型,最常用的是这些指标:音质、人声、旋律、编曲、中文咬字、Prompt理解。这些能力依然重要。随着多模态进入音乐生成,另一个维度会越来越关键:模型到底能从你的素材里读出多少东西。
同样一张照片:普通模型可能只看到“海边、日落、浪漫”;更强的模型可能读到:人物很小,画面大量留白,整体色温温暖,人物却背对镜头——这种视觉关系更接近“怀念”或者“离开”。当这种理解进一步转化成音乐决策时,差距就会出现。旋律应该多克制?乐器应该多空?副歌要不要爆开?人声离听众应该近还是远?结尾应该留下余韵,还是完整收束?这时候AI音乐模型的能力已经开始从单纯的Music Generation,继续走向Content Understanding + Music Generation。先理解你的东西,再把它变成声音。
07
Prompt不会消失,它会越来越像“导演意见”
以前Prompt承担的是全部信息,以后素材会承担越来越多基础信息。图片告诉模型:这里发生了什么。Prompt则负责告诉模型:你希望它怎么理解。比如同一张雨夜街景,你可以补一句“这是失恋后的第一晚”,也可以说“这是终于下班回家的轻松”。画面没有变,音乐可能完全不同。所以Prompt真正重要的部分会逐渐从“描述素材”,转向表达人的主观意图。这一点反而会让创作更像创作。因为用户花时间思考的,不再只是“这个乐器英文叫什么”,而是“这张照片对我到底意味着什么”。Suno从Scenes走到V6,其实已经把方向写得很清楚:音乐生成正在接收越来越多音乐之外的输入。谱乐AI现在也已经把图片创作接进了Suno灵感模式。所以这次我更愿意把它理解成一次创作入口的变化。以前我们问“我要怎么把这个感觉写成Prompt”,现在可以先做另一件事:把那个感觉本身交给AI。照片、故事、记忆、画面先进去,音乐,再从里面出来。
RELATED
相关阅读
AI歌曲终于能“验明正身”了?Google把SynthID检测器开放给所有人